Escalar contêineres é mais do que simplesmente colocar um proxy na frente de um serviço e achar que está tudo resolvido. A escalabilidade vai além da simples distribuição e, no mundo dinâmico dos contêineres, há cinco recursos distintos necessários para garanti-la: novas tentativas, disjuntores, descoberta, distribuição, e monitoramento.
Neste post sobre a arte de escalar contêineres, vamos nos aprofundar no monitoramento.
Monitoramento
Monitoramento. Em uma era em que tudo parece estar ouvindo e/ou observando tudo, desde a velocidade com que dirigimos até o que há em nossa geladeira, essa palavra causa desconforto em muita gente. Podemos — e muitas vezes fazemos isso — usar a palavra “visibilidade” em seu lugar, mas esse sofisma semântico não muda o que estamos fazendo: estamos observando atentamente.
Tudo relacionado à escalabilidade depende do monitoramento, ou seja, de conhecer o estado dos recursos entre os quais você distribui as solicitações. Enviar uma solicitação para uma “zona morta” porque o recurso falhou ou foi desativado recentemente é como entrar em uma rua sem saída. É uma perda de tempo.
O monitoramento pode assumir várias formas. Há o monitoramento do tipo “consigo chegar até você?”, feito por um ping na camada de rede. Há o monitoramento do tipo “você está em casa?”, feito por meio de uma conexão TCP. E há o “você está atendendo à porta?”, feito por meio de uma solicitação HTTP. Por fim, há o monitoramento do tipo “já tomou seu café?”, que determina se o serviço está respondendo corretamente ou não.
Além de simplesmente verificar a integridade e a execução de um serviço, há também o monitoramento de desempenho. A rapidez com que o serviço respondeu é crucial se você distribui as solicitações com base nos tempos de resposta. Mudanças repentinas no desempenho podem indicar problemas, o que significa que esses dados têm relevância histórica e também precisam ser monitorados.
Há o monitoramento ativo (deixe-me enviar uma solicitação real!), o monitoramento sintético (deixe-me enviar uma solicitação simulada) e o monitoramento passivo (vou apenas ficar aqui observando o que acontece com uma solicitação real). Cada um tem seus prós e contras, e todos são métodos válidos de monitoramento. O importante é que o proxy consiga determinar o status: está funcionando? está fora do ar? já saiu de cena junto com Elvis?
Alcançabilidade, disponibilidade e desempenho são aspectos do monitoramento necessários para garantir a escalabilidade. Isso significa que não se trata apenas de monitorar, mas também de garantir que os proxies de balanceamento de carga tenham informações atualizadas sobre o status de cada recurso ao qual possam direcionar uma solicitação.
Se você considerar a natureza dos contêineres e a tendência de combiná-los com uma arquitetura baseada em microsserviços, verá que o monitoramento rapidamente se torna uma tarefa assustadora. Isso ocorre porque o modelo mais popular de balanceamento de carga em ambientes de contêineres utiliza proxies de encaminhamento (e sidecars). Ambos exigem que cada nó conheça a integridade e o estado de cada recurso para o qual possa precisar enviar uma solicitação. Isso significa monitorar praticamente todos os recursos.
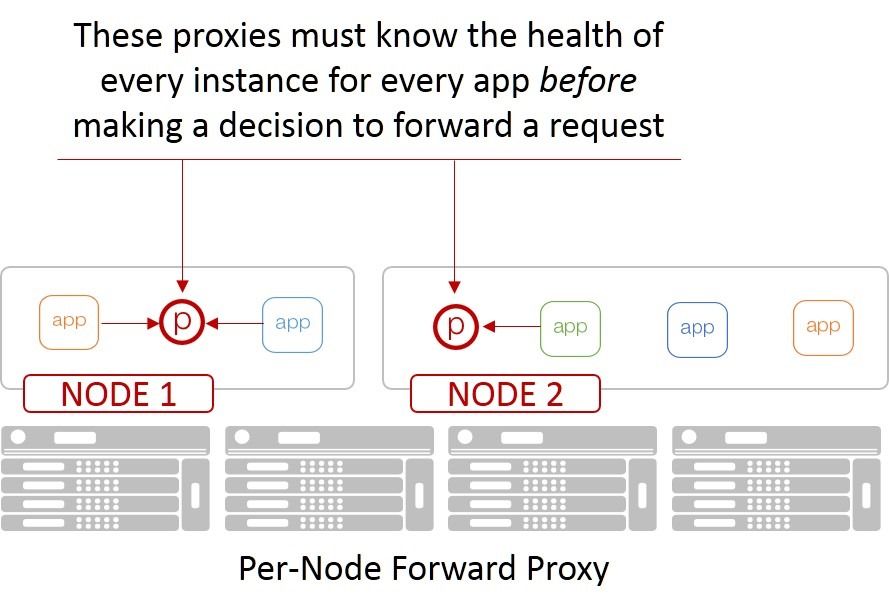
Como você pode imaginar, não é muito eficiente que um determinado recurso gaste seus próprios recursos limitados respondendo a quinze ou vinte proxies de encaminhamento sobre seu status. O monitoramento em um modelo como esse tem um impacto negativo significativo tanto no desempenho quanto na capacidade, o que torna a escalabilidade ainda mais difícil.
O monitoramento nunca teve um impacto tão significativo na escalabilidade quanto o que estamos observando com os contêineres.
Ainda assim, isso é crucial — como observado acima —, pois não queremos perder tempo com recursos que não levam a lugar algum se pudermos evitar.
Os desafios do monitoramento necessário são um dos motivos pelos quais a malha de serviços continua ganhando preferência (e força) como o futuro modelo de escalabilidade em ambientes de contêineres.
Porque o monitoramento não é opcional, mas também não deve ser um fardo.
Sobre o autor

Lori MacVittie é engenheira distinta e evangelista-chefe no Escritório do CTO da F5, com ampla experiência em entrega de aplicações, estratégia de automação e infraestrutura. Ela é conhecida por transformar complexidade em clareza, seja definindo diretrizes para agentes de IA, analisando arquiteturas multinuvem frágeis ou investigando os limites de sistemas escaláveis. Ela acumula mais de trinta anos de experiência no setor, abrangendo desenvolvimento de aplicações, arquitetura de TI e operações de redes e sistemas. Antes de ingressar na F5, atuou como editora de tecnologia e recebeu diversos prêmios. MacVittie tem mestrado em Ciência da Computação e é uma autora prolífica, com publicações que abrangem segurança, nuvem e arquitetura empresarial. Ela também é uma entusiasta de jogos de tabuleiro e videogames, além de ter opiniões assumidamente fortes sobre queijos.
Mais publicações de Lori Mac VittiePublicações relacionadas no blog

Entrega e proteção de agentes de IA em fábricas de IA: F5 para a arquitetura de referência NVIDIA OpenShell para agentes de IA seguros
As soluções da F5 ampliam a Arquitetura de Referência NVIDIA OpenShell para agentes de IA seguros.

Como medir – e minimizar – o custo total de propriedade do seu Kubernetes
O Kubernetes pode ser baixado e executado gratuitamente, mas sua manutenção está longe de não ter custos. Assim como outras grandes plataformas de código aberto que são “gratuitas” apenas em um sentido simplista, o Kubernetes quase certamente exigirá investimentos para ser implantado e operado.
As-Code: a pilha de TI contínua
Infraestrutura, configuração, pipeline, operações. De repente, tudo é “como código”. Lori MacVittie busca esclarecer a terminologia e identificar os diferentes componentes de uma stack contínua de TI.
O estado da entrega de aplicações em 2017: automação, APIs e DevOps
Explore o relatório State of Application Delivery de 2017. Leia o blog retrospectivo da F5 sobre o início da ascensão das redes declarativas e dos pipelines de DevOps.
DevOps Summit: onde a rede foi convidada para a festa
No DevOps Summit NY, falou-se muito não apenas sobre DevOps, mas também sobre contêineres, IoT e microsserviços. As sessões se concentraram não só na mudança cultural necessária para crescer em escala com uma abordagem DevOps, mas também fizeram questão de incluir...
F5 e Nutanix convergem em infraestrutura no .NEXT
Aplicações empresariais como Microsoft SharePoint e Exchange, juntamente com a VDI, continuam sendo a espinha dorsal da sua empresa. A produtividade, embora não seja tão atraente quanto o lucro, é um fator essencial para o sucesso das operações empresariais atuais. Deixar de...