Segurança Zero Trust: por que ela é importante (e não apenas para o acesso)
Resumo
Um dos principais temas relacionados ao acesso a redes e aplicações nos últimos anos tem sido o conceito de “zero trust”. Neste artigo, mostramos como, em sua essência, o zero trust pode ser caracterizado por um pequeno conjunto de princípios simples que podem ser aplicados não apenas ao acesso, mas também de forma mais ampla em toda a área de segurança cibernética.
Este artigo apresenta uma estrutura que abrange os principais conceitos de confiança zero, relacionando-os ao cenário de negócios atual que orienta os líderes empresariais de segurança de aplicações. Por fim, este artigo caracteriza o conjunto de princípios da confiança zero — a base das ferramentas e implementações de segurança que combatem as ameaças atuais e emergentes, que serão o foco de um próximo artigo.
Este documento tem dois objetivos: primeiro, transmitir a mentalidade de segurança que os líderes de negócios de aplicações devem adotar e, segundo, apresentar uma estrutura para profissionais de segurança que aprofundaremos em futuros white papers.
ZTS: Comece pelos princípios, não pelas tecnologias
O termo “zero trust” está associado a diversos conceitos em diferentes níveis de abstração: às vezes, a uma arquitetura de solução específica; em outras, a uma recomendação de uso de tecnologias específicas; e, em outros casos, a uma característica de um produto. Acreditamos que a segurança zero trust é, em sua essência, uma mentalidade — um sistema de crenças — da qual surgem técnicas e táticas que utilizam tecnologias específicas e que podem ser aplicadas para enfrentar um amplo espectro de ameaças à segurança.
O sistema de crenças que fundamenta a segurança Zero Trust (ZTS) pode ser visto como o próximo passo na evolução de uma mentalidade de segurança que começou com a “defesa em profundidade” anos atrás. A defesa em profundidade se baseia na crença de que, embora qualquer barreira defensiva isolada tenha uma probabilidade pequena, mas real, de ser violada, a adição de mais camadas de proteção aos ativos essenciais reduz essa probabilidade, retardando os invasores e, ao mesmo tempo, obrigando-os a empregar mais recursos para realizar um ataque bem-sucedido.
O modelo de confiança zero representa o amadurecimento dessa mentalidade em três dimensões:
- Primeiro, ele evolui a premissa de proteção de um conjunto de simples “filtros” que controlam o acesso à aplicação para um conjunto de proteções mais adequado aos ativos, aplicado de forma contextual a qualquer transação do sistema. A mentalidade em cada transação é entender: Quem está tentando realizar qual ação sobre quem. Tanto “quem” realiza a ação quanto “quem” é seu alvo podem ser qualquer componente dentro do sistema ou que o utilize, seja uma pessoa, um processo automatizado ou um trecho de código. O conceito de identidade é fundamental para definir quem realiza a ação e quem é seu alvo, e o conceito de privilégios concedidos a uma identidade é usado para codificar o que pode ser feito.
- Em segundo lugar, considera a avaliação da decisão de segurança não como estática e absoluta, mas sim como mais dinâmica e adaptativa, devendo ser continuamente reavaliada à luz dos comportamentos observados. A decisão sobre como tratar cada transação — permitir a interação, bloqueá-la, obter um grau maior de confiança e assim por diante — também deve considerar o contexto mais amplo dos negócios e, especificamente, a relação entre risco e benefício.
- Por fim, parte-se do princípio de que, independentemente de quantas camadas de proteção sejam implementadas, um adversário suficientemente motivado ou com sorte conseguirá violar ou contornar as proteções. Portanto, a detecção em tempo hábil de qualquer comprometimento e a mitigação de tentativas de exploração de vulnerabilidades também devem ser parte fundamental da estratégia geral.
Essa evolução tem sido, em parte, resultado do tempo e da experiência, mas é cada vez mais impulsionada pela convergência de duas outras tendências de segurança de aplicações. Especificamente, as arquiteturas de aplicações atuais abrem um leque muito maior de possíveis vulnerabilidades — sobretudo ameaças vindas de “dentro” da infraestrutura da aplicação — que podem ser exploradas devido à crescente sofisticação dos adversários atuais. Felizmente, os avanços simultâneos nas ferramentas de segurança, especialmente quando usadas em conjunto com recursos modernos de coleta e análise de dados, têm permitido a implementação prática de componentes essenciais da estratégia de defesa.
O restante desta introdução apresenta uma visão geral da estrutura que fundamenta nossa abordagem à segurança de confiança zero, bem como de seu escopo. A partir daí, as seções seguintes aprofundam a definição do problema e sua relação com outras abordagens contemporâneas de confiança zero, levando a uma discussão sobre as convicções fundamentais — o “porquê” — que devem orientar a escolha das tecnologias que compõem a solução e sua aplicação. Artigos futuros se aprofundarão no “como” — os requisitos impostos a tecnologias específicas, como autenticação, controle de acesso e análise de dados assistida por IA, no contexto do modelo de maturidade de confiança zero.
ZTS: Tudo começa com o porquê
A abordagem “Comece pelo Porquê”, de Simon Sinek, é uma ferramenta eficaz para comunicar o framework ZTS, conforme ilustrado na Figura 1 abaixo. Você pode analisar esse gráfico de fora para dentro, começando pelas categorias de ameaças que o ZTS combate, passando pelos métodos de segurança utilizados e, por fim, chegando aos princípios comuns que fundamentam tudo isso. Ou pode analisá-lo de dentro para fora, começando pelas convicções fundamentais como norte, das quais surgem as ferramentas e técnicas adequadas, que permitem enfrentar uma ampla variedade de ameaças.
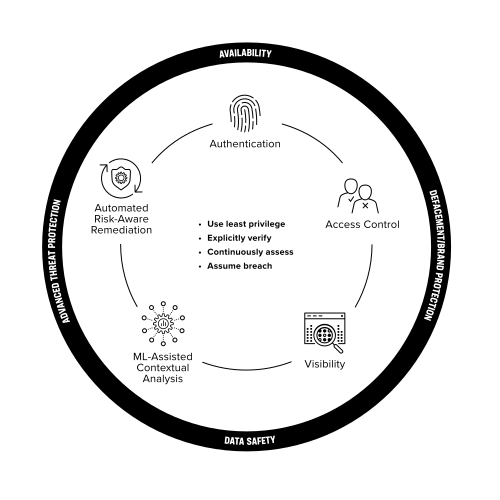
As próximas seções exploram em detalhes cada camada concêntrica deste diagrama, mas, em resumo:
- As crenças fundamentais da abordagem decorrem da formulação do caso de uso como:
“Quem está tentando fazer o quê (ação) a quem?”- Para determinar Quem e a Quem, verifique explicitamente qualquer comprovação de identidade.
- Depois de determinar Quem, use o princípio do menor privilégio para limitar O que pode ser feito.
- Avalie e reavalie continuamente os três fatores: Quem, O quê e A quem, e continue verificando a conformidade com as restrições da política.
- Sempre presuma que ocorrerão violações e comprometimentos de segurança. Esteja preparado para intervir se a ação (O quê para Quem), com base em uma análise de risco versus benefício (a probabilidade de fraude na autenticação, ponderada pelo impacto nos negócios de uma aprovação indevida de transação), exceder um limite de segurança aceitável previamente determinado.
- Os métodos utilizados são:
- Autenticação e controle de acesso para determinar Quem com certo grau de confiança e, em seguida, limitar os privilégios relativos a Quais (ações) devem ser permitidas a essa identidade em relação a um alvo específico, definido como Quem.
- Visibilidade e análise assistida por aprendizado de máquina para observar e avaliar continuamente o contexto completo de cada transação – Quem fazendo O quê a Quem.
- Remediação automatizada com reconhecimento de riscos para intervir em uma transação quando o nível de risco-retorno ultrapassa o limite de tolerância especificado.
- Combata uma ampla variedade de ataques cibernéticos aplicando estes métodos:
- Ataques tradicionais, como desfiguração de sites ou exfiltração de dados – Você pode combater esses ataques detectando o comprometimento de identidades ou a escalada de privilégios e usando técnicas de autenticação e controle de acesso para limitar quem pode fazer o quê por meio de políticas.
- Ataques à disponibilidade/DDoS -- Combata esses ataques combinando autenticação e controle de acesso com medidas de mitigação baseadas em risco. Por exemplo, bloqueie (ou limite a taxa de) acesso de agentes não autenticados ou com autenticação fraca que tentem realizar transações com alto consumo de recursos.
- Ameaças avançadas, como ransomware ou ataques à cadeia de suprimentos -- Você pode combater essas ameaças detectando mudanças e anomalias nos comportamentos de quem está fazendo o quê a quem, novamente em conjunto com medidas de correção baseadas em riscos.
O escopo do ZTS
A segurança de confiança zero abrange de forma integral toda a pilha de aplicações, infraestrutura e entrega, e deve se estender por todo o pipeline de desenvolvimento. Mais especificamente, isso deve incluir:
- Toda a pilha de aplicações e infraestrutura, de ponta a ponta
- Base de hardware computacional, incluindo servidores, placas de interface de rede, coprocessadores e componentes da placa-mãe
- Firmware de baixo nível e BIOS para o hardware.
- O sistema operacional da camada mais baixa, como o hipervisor ou o núcleo de execução.
- O sistema operacional no nível da aplicação ou do contêiner.
- Componentes de aplicativos de terceiros incorporados, sejam comerciais ou de código aberto.
- Qualquer software aplicativo desenvolvido internamente ou sob medida.
- Stack completa de entrega de aplicações, de ponta a ponta
- A cadeia de suprimentos usada para a manutenção contínua e as atualizações de cada elemento da pilha, de cima a baixo.
- Quaisquer componentes de entrega de aplicações em linha, como firewalls, balanceadores de carga, gateways de API, controladores de entrada/saída/malha e dispositivos de mitigação de fraudes em linha.
- Quaisquer componentes de entrega de aplicações que afetem indiretamente o tratamento do tráfego, como resolvedores do Sistema de Nomes de Domínio (DNS), ou que recebam metadados indiretamente, como soluções de gerenciamento de informações e eventos de segurança (SIEM) ou serviços de identidade federada.
Tradicionalmente, o foco do modelo Zero Trust tem sido direcionado às equipes de desenvolvimento e entrega de aplicações, frequentemente representadas pelas personas de Dev, DevOps, DevSecOps e SRE. Destacamos isso principalmente para chamar a atenção para o panorama mais amplo: uma abordagem abrangente de Zero Trust deve, idealmente, incluir personas e infraestruturas não tradicionais, além de fluxos de trabalho adicionais, como a estratégia de compras da cadeia de suprimentos.
Definição do problema
Uma das principais prioridades dos CIOs e CISOs é modernizar a tecnologia da informação para ajudar a acelerar os negócios. Eles também desempenham um papel fundamental na governança de riscos corporativos. Seu objetivo é ajudar a empresa a encantar os clientes com novas experiências digitais, aumentar a eficiência operacional por meio da conectividade digital com terceiros e permitir que os funcionários sejam produtivos de qualquer lugar, minimizando os riscos para os negócios. Isso exige que as equipes lideradas pelos CIOs e CISOs deem aos funcionários liberdade para usar as tecnologias, arquiteturas e práticas recomendadas mais recentes para ganhar agilidade e, ao mesmo tempo, atribuam a essas mesmas pessoas a responsabilidade de adotar medidas de segurança adequadas e estabelecer controles sobre o comportamento das pessoas, as informações que acessam e a tecnologia que utilizam, a fim de evitar a exposição a perdas.
As organizações devem compreender e controlar os riscos relacionados a mudanças nas condições de mercado e macroeconômicas, no comportamento do consumidor, na cadeia de suprimentos e na exposição a ameaças de segurança. Uma avaliação precisa dos riscos e a capacidade de adotar rapidamente medidas de mitigação representam uma vantagem competitiva para as empresas. Neste documento, nos concentramos nos riscos decorrentes da exposição a ameaças de segurança, que, entre outras consequências, podem causar perda de propriedade intelectual, interrupção de processos de negócios, perda de informações de identificação pessoal e multas impostas por órgãos reguladores. O risco de segurança pode ser calculado por meio da avaliação dos seguintes aspectos da situação em análise:
- Valor dos ativos envolvidos
Os ativos envolvidos nas transações têm diferentes níveis de importância. Por exemplo, um banco de dados que contém informações de identificação pessoal é mais valioso do que um banco de dados que lista os pontos de venda que comercializam produtos fabricados pela empresa. As equipes de segurança e de TI podem usar um processo determinístico para criar um inventário de todos os ativos, categorizados por uma pontuação que representa o “valor” de cada ativo. - Impacto do comprometimento
A natureza do comprometimento determina o impacto associado a ele. Por exemplo, o impacto do roubo de informações de um repositório de dados que contém informações de identificação pessoal é muito maior do que o da interrupção da disponibilidade desse repositório. Embora seja uma avaliação um pouco mais subjetiva, é possível listar vários tipos de comprometimento e atribuir a eles uma pontuação de “impacto”. - Probabilidade de comprometimento
A probabilidade de uma transação levar ao comprometimento de um ativo é o fator menos determinístico na avaliação do risco associado à transação. Os seres humanos não conseguem lidar com o volume de observações necessárias, por isso as organizações utilizam aprendizado de máquina e inteligência artificial para aumentar a confiança no cálculo da probabilidade de comprometimento.
O desafio é calcular o risco associado a cada transação quase em tempo real e tomar as medidas de mitigação adequadas para controlar o impacto de um possível comprometimento.
Reconhecendo o problema
As demandas por aceleração dos negócios levam à adoção de novas práticas que agravam os riscos de segurança cibernética. Discutimos esse ponto com mais detalhes a seguir.
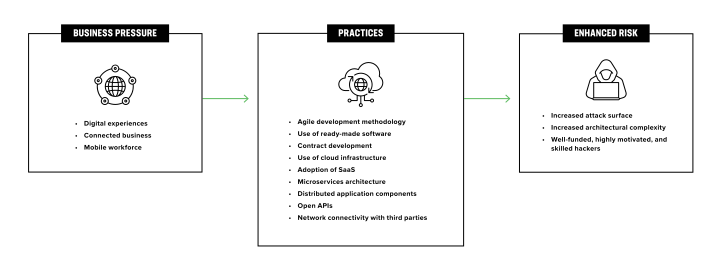
- Demandas de aceleração dos negócios
- Experiências digitais
Os consumidores têm um desejo insaciável por experiências digitais e exigem melhorias frequentes em diversas plataformas (PCs, tablets e celulares). - Negócios conectados
Os processos de negócios digitais exigem conectividade com parceiros, fornecedores, distribuidores e serviços prestados por outras empresas. - Força de trabalho móvel
Os funcionários precisam poder acessar os aplicativos de negócios de qualquer lugar para executar suas tarefas com eficiência.
- Experiências digitais
- Práticas para atender às demandas do negócio
- Metodologia de desenvolvimento ágil
As empresas passaram a adotar a abordagem de desenvolvimento ágil, incremental e iterativa, com forte foco na satisfação do cliente, em vez da abordagem sequencial em cascata, que prioriza a entrega dos projetos dentro do prazo. - Uso de software pronto
Para oferecer novas experiências digitais o mais rápido possível, os desenvolvedores reutilizam códigos disponibilizados como código aberto por seus colegas do setor. - Desenvolvimento terceirizado
Terceirizar o trabalho de desenvolvimento ajuda as empresas a ampliar suas equipes conforme a demanda. - Uso de infraestrutura em nuvem
A agilidade, a flexibilidade, a escalabilidade e a facilidade de uso da nuvem permitem que os desenvolvedores obtenham a infraestrutura necessária sob demanda. - Adoção de SaaS
O software como serviço (SaaS) é vantajoso para aplicações voltadas às operações empresariais, pois reduz significativamente o esforço de adquirir, implantar e manter essas aplicações em data centers privados. - Arquitetura de microsserviços
As equipes usam microsserviços para alcançar a entrega contínua e reduzir o tempo de lançamento no mercado. - Componentes de aplicações distribuídas
As organizações ganham eficiência ao executar microsserviços em uma infraestrutura que oferece as melhores ferramentas para desenvolver ou disponibilizar as funcionalidades do serviço. As extensões recentes dos fluxos de trabalho legados são implementadas com arquiteturas de aplicações modernas que precisam se comunicar com os elementos legados, e ambos costumam ser executados em infraestruturas diferentes. - APIs abertas
Um ecossistema de serviços variados é mais eficiente do que uma empresa desenvolver todos os serviços por conta própria. - Conectividade de rede com terceiros
As empresas se conectam a seus parceiros, fornecedores e distribuidores por meio de túneis criptografados para automatizar e otimizar os processos de negócios.
- Metodologia de desenvolvimento ágil
- Maior risco de segurança
- Ampliação da superfície de ataque
O uso de software de terceiros e bibliotecas de código aberto cria oportunidades para ataques à cadeia de suprimentos, e todas as vulnerabilidades do software desenvolvido externamente são herdadas. Desenvolvedores contratados são motivados a entregar as funcionalidades no prazo, e a segurança não é uma preocupação para eles. Além disso, depois que entregam o software e deixam o projeto, revisar o código e encontrar brechas de segurança se torna uma tarefa difícil e demorada para as equipes internas. Os sprints ágeis são muito eficientes na entrega de funcionalidades, mas o ritmo acelerado de desenvolvimento deixa pouco tempo para auditorias e testes de segurança detalhados. Um único microsserviço vulnerável capaz de se comunicar com outros microsserviços aumenta o risco de segurança de todo o sistema. Embora a interconexão entre empresas melhore a eficiência operacional, uma consequência grave é que brechas de segurança em qualquer uma delas afetam todas as demais. Os invasores encontram o elo mais fraco para se espalhar pelas outras. Uma vulnerabilidade ou falha de segurança na plataforma SaaS ou na infraestrutura de nuvem se torna um vetor de ataque adicional, e o modelo de responsabilidade compartilhada pode dificultar a detecção e a correção precoces. - Maior complexidade arquitetural
Os componentes de aplicações distribuídas, desenvolvidos com diferentes arquiteturas e implantados em múltiplas infraestruturas, têm necessidades distintas de segurança e conformidade. Isso dificulta o trabalho das equipes de segurança na concepção e implementação de mecanismos adequados para proteger aplicações e dados corporativos e atender aos requisitos de conformidade regulatória. - Hackers bem financiados, altamente motivados e qualificados
Da Operação Aurora, em 2010, ao Solargate, em 2020, vivenciamos uma década de ataques cibernéticos avançados que só foram descobertos depois de causar grandes danos. Ocorreram violações em organizações equipadas com as melhores tecnologias de segurança, operadas por equipes de segurança altamente capacitadas. Os invasores permaneceram na infraestrutura de TI dessas organizações por longos períodos antes de serem detectados. Propriedade intelectual e informações de identificação pessoal foram roubadas, operações de negócios foram interrompidas e organizações foram mantidas reféns de ransomware, mesmo com as equipes de TI e segurança indo muito além do cumprimento das regulamentações destinadas a impedir ataques cibernéticos.
- Ampliação da superfície de ataque
Diretrizes do governo dos EUA
Após uma série de ataques cibernéticos persistentes contra diversos órgãos governamentais federais, estaduais e locais dos EUA e várias empresas americanas, o presidente Joe Biden emitiu uma ordem executiva para melhorar a segurança cibernética do país em 12 de maio de 2021. Um dos principais pontos dessa ordem é que os órgãos governamentais utilizem os princípios de confiança zero para se preparar para ataques cibernéticos. Em seguida, em 26 de janeiro de 2022, o governo Biden publicou um memorando do Escritório de Gestão e Orçamento (OMB) destinado aos dirigentes dos departamentos e órgãos do Poder Executivo. Esse memorando do OMB “estabelece uma estratégia federal de arquitetura de confiança zero (ZTA), exigindo que os órgãos atendam a padrões e objetivos específicos de segurança cibernética até o final do ano fiscal de 2024, a fim de reforçar as defesas do governo contra campanhas de ameaças cada vez mais sofisticadas e persistentes.”1 Tanto a ordem executiva quanto o memorando do OMB fazem referência à arquitetura de confiança zero descrita na publicação SP 800-207 do Instituto Nacional de Padrões e Tecnologia (NIST), publicada em agosto de 2020, e exigem que os órgãos governamentais a sigam.
Arquiteturas de confiança zero e modelos de maturidade
Especialistas de referência em órgãos governamentais e no setor privado publicaram artigos que ajudam a explicar a arquitetura de confiança zero e oferecem orientações sobre a melhor forma de adotá-la. Resumimos a seguir as ideias contidas nesses artigos. Ressaltamos que a essência das ideias e sugestões apresentadas nesses artigos é examinar cada transação para avaliar Quem está tentando realizar Qual ação sobre Quem e decidir, em tempo real, se a transação deve ser permitida ou bloqueada com base no cálculo do risco associado a ela.
Instituto Nacional de Padrões e Tecnologia (NIST): Zero trust architecture
A equipe do NIST enumera os princípios de confiança zero e define uma arquitetura abstrata de confiança zero (ZTA) em sua publicação NIST SP 800-207.2 Além disso, discute variações das abordagens de confiança zero e descreve diferentes maneiras de implantar a arquitetura abstrata.
As principais abstrações discutidas no documento são o Ponto de Decisão de Políticas (PDP) e o Ponto de Aplicação de Políticas (PEP), que trabalham em conjunto. O Ponto de Decisão de Políticas é composto pelo Mecanismo de Políticas (PE) e pelo Administrador de Políticas (PA). O Mecanismo de Políticas usa um algoritmo de confiança para decidir se um sujeito deve receber acesso a um recurso. Essa decisão é executada pelo Administrador de Políticas, que se comunica com o Ponto de Aplicação de Políticas para permitir ou impedir uma nova sessão e modificar ou encerrar uma sessão existente. Além disso, o documento discute variações do algoritmo de confiança, componentes de rede para um ambiente de confiança zero e diversos casos de uso ou cenários de implantação. Por fim, são analisadas as maneiras pelas quais invasores podem comprometer a arquitetura de confiança zero, para que os responsáveis pela implementação estejam cientes das ameaças e tomem as medidas adequadas para proteger os componentes de sua arquitetura de confiança zero.
Agência de Segurança Cibernética e de Infraestrutura (CISA): Modelo de maturidade de confiança zero
Com o objetivo de auxiliar as agências a desenvolver seus planos de confiança zero, especialistas de referência da Agência de Segurança Cibernética e de Infraestrutura (CISA) publicaram um modelo de maturidade de confiança zero (https://www.cisa.gov/zero-trust-maturity-model).3 O trabalho se baseia na arquitetura abstrata de confiança zero descrita na publicação NIST SP 800-207. Os autores identificaram cinco áreas e recomendam que as organizações avancem de forma consistente na adoção dos princípios de confiança zero em cada uma delas. As áreas são: (i) identidade, (ii) dispositivo, (iii) rede, (iv) carga de trabalho de aplicações e (v) dados. Eles recomendam o uso de visibilidade e análise, bem como de automação e orquestração, em cada uma das cinco áreas.
O documento apresenta um modelo de maturidade de alto nível que abrange os cinco pilares fundamentais de confiança zero identificados anteriormente e, em seguida, aprofunda cada área. As organizações podem usar o modelo de maturidade para entender seu estado atual e definir um caminho iterativo rumo ao estado ideal.
Departamento de Defesa (DOD): Arquitetura de referência de confiança zero
Após a descoberta dos ataques à Solar Winds, a Agência de Segurança Nacional (NSA) emitiu orientações recomendando que as equipes de segurança cibernética adotassem um modelo de segurança Zero Trust em seu documento “Adotando um modelo de segurança Zero Trust”.4 Especialistas da equipe conjunta de engenharia Zero Trust da Agência de Sistemas de Informação de Defesa (DISA) e da Agência de Segurança Nacional elaboraram a arquitetura de referência Zero Trust do Departamento de Defesa (DOD).5 Os autores expressam a necessidade de adoção do Zero Trust com a seguinte declaração: “As vulnerabilidades expostas por violações de dados dentro e fora do DOD demonstram a necessidade de um modelo de segurança cibernética novo e mais robusto, que facilite a tomada de decisões bem fundamentadas e baseadas em riscos”.6
Esta arquitetura de referência baseia suas recomendações nas abstrações definidas no documento de arquitetura de confiança zero NIST SP 800-207. O documento apresenta um modelo operacional de alto nível e descreve seus elementos em detalhes. Também inclui um modelo de maturidade de alto nível e o mapeamento de capacidades para aplicar os princípios de confiança zero a diversas áreas de interesse. Em conjunto, esses documentos ajudam as organizações a avaliar seu estado atual e a elaborar um plano.
Gerenciando riscos e governança com os princípios de confiança zero
Adotar uma postura que “pressupõe a violação” e seguir os princípios de confiança zero pode ajudar as organizações em suas práticas de gestão de riscos e governança. Os princípios de confiança zero de “monitoramento contínuo” e “verificação explícita” dos agentes envolvidos nas transações permitem que as organizações estabeleçam uma pontuação de risco dinâmica para todos os agentes e suas atividades. Isso está alinhado à recomendação do Gartner de usar a metodologia de “avaliação contínua e adaptativa de risco e confiança” (CARTA) para aprimorar os programas de segurança existentes. Adotar o princípio de permitir o acesso aos recursos apenas com os privilégios mínimos necessários reduz o risco de perdas mesmo após uma violação. As informações geradas pelo monitoramento contínuo e pela verificação explícita também são úteis para gerar relatórios de conformidade.
A mentalidade em mais detalhes
Esta seção tem como objetivo abordar a mentalidade — o sistema de crenças, o “porquê” — que orienta a estratégia e as decisões sobre as ferramentas e a arquitetura que uma empresa deve adotar para a segurança Zero Trust. De fato, a motivação por trás de todos os métodos e tecnologias que compõem as soluções atuais de Zero Trust pode ser resumida em quatro princípios fundamentais simples. Esta seção começa com uma apresentação desses princípios, seguida de uma discussão sobre como aplicá-los no contexto mais amplo do ciclo de vida de desenvolvimento de aplicações — ou seja, como considerar esses princípios desde o início, na fase de projeto, e também na operação, durante a implantação e a execução da aplicação.
Princípios operacionais de confiança zero
Se entendermos que as soluções de confiança zero visam fundamentalmente estabelecer confiança nas interações entre sistemas – “Quem está fazendo O quê a Quem?” –, então o estabelecimento de um nível de confiança adequado à interação pode ser dividido em quatro componentes.
Verifique explicitamente
Como o nome sugere, a mentalidade de confiança zero é: “Não confie cegamente, sempre verifique.” Portanto, qualquer agente no sistema — quem e com quem nas interações do sistema — deve ser capaz de:
- Atestar sua identidade, incluindo o caso especial de uma identidade “anônima”, se o sistema permitir interações originadas de ou destinadas a identidades anônimas — como navegadores anônimos em um sistema de reservas de passagens aéreas. Para todas as outras identidades, o agente deve ser capaz de declarar Quem é, em um espaço de nomes aceito pelo sistema.
- Receber e validar “provas” complementares da identidade declarada pelo ator (para qualquer identidade declarada não anônima). A natureza das “provas” — senhas, certificados, comportamentos etc. — pode variar, assim como sua robustez, mas o sistema deve ser capaz de determinar algum grau de confiança na declaração de identidade. Sistemas simples podem adotar uma visão binária, de sim ou não, quanto à confiança nas provas, enquanto sistemas mais avançados podem ter uma pontuação numérica de confiança que possa ser explicitamente referenciada como parte de uma política baseada na relação entre risco e recompensa. Observe que o sistema também pode aumentar ou reduzir a confiança por outros meios, como a resposta a um desafio ativo ou até mesmo a observação passiva do comportamento do ator.
- Avaliar e ajustar a confiança na identidade atestada, com base na contextualização adicional do comportamento atual em relação aos comportamentos anteriores. Por exemplo, o sistema pode manter metadados históricos sobre o ator, como sua geolocalização anterior e atual, plataformas de hardware, endereços IP, reputação e assim por diante, a fim de aumentar ou diminuir a confiança na “prova” de identidade.
Além disso, o princípio de verificar explicitamente pode ser aplicado não apenas à identidade, mas também à ação — o que é feito na transação. Um caso de uso comum é aquele em que a ação é expressa como uma chamada de API, como uma API para realizar uma consulta a um banco de dados. Nesse exemplo, o princípio de verificar explicitamente pode ser usado não apenas para ter confiança na identidade do agente que chama a API, mas também para verificar se a ação da API está sendo usada corretamente, por exemplo, verificando se os parâmetros passados à API estão em conformidade com as restrições apropriadas.
Em uma mentalidade madura de confiança zero, a “prova” quase nunca é absoluta. Credenciais de identidade podem ser roubadas e dispositivos podem ser comprometidos; as restrições dos parâmetros de API costumam ser incompletas. Portanto, o termo “confiança” no contexto de confiança zero deve ser interpretado mais como uma indicação da probabilidade de que a identidade atestada ou os parâmetros da transação sejam legítimos. Assim, o nível de “confiança” deve ser considerado um fator fundamental, mas não o único, na decisão de permitir, bloquear ou inspecionar uma transação mais a fundo.
Privilégio mínimo
Uma vez estabelecido um nível aceitável de “confiança” nos atores que participam de uma transação, a abordagem de confiança zero exige que o ator (normalmente, o solicitante, o “Quem”) receba apenas o conjunto mínimo de privilégios necessários para realizar aquilo para o qual foi projetado nesse sistema. Esse princípio representa o que também é chamado de “modelo de segurança positivo” — uma abordagem em que todas as ações são bloqueadas por padrão, e privilégios específicos são concedidos apenas conforme necessário para o funcionamento do sistema. Por exemplo, um sistema de reservas pode permitir que usuários anônimos consultem os horários dos voos, mas — conforme os requisitos de projeto da aplicação — pode não permitir que um usuário anônimo reserve um voo.
Esses privilégios podem se aplicar a atores individuais ou a classes de atores. Normalmente, os consumidores de uma aplicação são atores humanos ou agentes que atuam em nome de pessoas e são agrupados em classes, como “usuários anônimos”, “clientes”, “parceiros” ou “funcionários”. As classes de atores menos confiáveis geralmente precisam atingir um limiar de confiança menor para serem autenticadas, mas também têm acesso a menos APIs ou a APIs menos sensíveis. Atores internos à aplicação ou à sua infraestrutura, como serviços ou contêineres específicos dentro de uma aplicação, muitas vezes podem ter privilégios mais personalizados, como “somente os contêineres <X> e <Y> podem acessar o banco de dados; somente <X> pode gravar no armazenamento de objetos, mas <Y> e <Z> podem ler os dados nele armazenados”.
Uma consideração importante para a implementação do princípio do privilégio mínimo é buscar aplicá-lo de forma mais personalizada e planejada.7 Especificamente, em vez de aplicar um conjunto genérico de privilégios a todos os atores ou a uma classe de atores, uma implementação madura de zero trust deve ter uma visão mais granular de qual ação está sendo tentada. Por exemplo, em um nível bastante genérico, pode-se conceder o privilégio de “acesso ao sistema de arquivos”, mas “leitura do sistema de arquivos” é uma especificação mais precisa do privilégio realmente necessário, o que resulta em uma implementação de alta qualidade do modelo de segurança positiva.
Por fim, aplicações mais sofisticadas do princípio do menor privilégio podem atuar em conjunto com implementações maduras do princípio de “verificar explicitamente”, considerando os privilégios autorizados para um ator não como absolutos, mas como condicionados ao grau de confiança fornecido pela autenticação. Assim, os privilégios são concedidos somente se a confiança na identidade atestada (Quem) atingir um limiar mínimo, com limiares específicos para a ação que se está tentando executar. Por exemplo, uma ação de impacto particularmente alto (como desligar o sistema) pode exigir um grau de confiança de 90% ou mais de que o ator seja um administrador. Nesse exemplo, se a confiança do sistema na identidade for de apenas 80% no momento da tentativa de desligamento, o sistema exigirá uma verificação adicional para aumentar a pontuação de confiança na identidade atestada antes de permitir a ação.
Avalie continuamente
A verificação explícita e o privilégio mínimo são conceitos fundamentais; no entanto, o princípio da avaliação contínua reflete o fato de que esses princípios devem ser avaliados continuamente, no sentido de que:
- Todas as transações devem estar sujeitas à verificação e ao controle de privilégios. Em outras palavras, não se deve inspecionar apenas um subconjunto de transações — como “a primeira transação em uma sessão de usuário” ou “as transações iniciadas por meio de uma carga de trabalho em contêiner Docker”. Embora isso possa parecer óbvio, muitas implementações de confiança zero não validam todas as transações, seja por falhas de projeto ou por falta de visibilidade. Deficiências comuns nessa área decorrem da aplicação da confiança zero apenas a agentes externos, mas não aos internos, e/ou da suposição de que uma decisão de confiança zero permanece válida por um longo período.
- Os principais fatores da avaliação – a confiança na identidade do agente e os direitos concedidos a ele – devem ser considerados dinâmicos e sujeitos a alterações. Por exemplo, a confiança em uma identidade pode aumentar ou diminuir ao longo do tempo, com base nos comportamentos observados e em metadados auxiliares, e qualquer política baseada em confiança deve, portanto, também se ajustar dinamicamente às mudanças nesse nível de confiança. Além disso, um nível de privilégio concedido anteriormente por uma política pode ser revogado pouco depois, ou o nível mínimo de confiança exigido para determinada ação pode mudar. Embora os prazos para alterações nas políticas variem – elas podem mudar lentamente (no ritmo dos processos operacionais humanos) ou rapidamente (por meio de agentes de governança automatizados) –, o sistema deve ser capaz de responder dinamicamente a essas alterações e respeitá-las.
Presuma uma violação
O último princípio parte do pressuposto de que existem adversários altamente motivados, em um contexto de paranoia saudável. Especificamente, a premissa é “presuma que seu ambiente já foi comprometido”, sendo “comprometimento” definido como “uma transação que deveria ter sido negada (com conhecimento e execução perfeitos), mas que acabou sendo permitida”. A causa raiz dessa falha pode ser um conhecimento imperfeito (por exemplo, uma pontuação de confiança indevidamente alta na autenticação, decorrente de credenciais fraudulentas não detectadas), limitações de implementação (por exemplo, a falta de granularidade suficiente na definição dos privilégios concedidos, como ter o privilégio de “abrir uma conexão de rede”, mas sem a capacidade de diferenciar com base na geolocalização do destino da conexão) ou uma implementação incompleta de confiança zero (por exemplo, não aplicar a confiança zero a componentes vulneráveis de código aberto usados internamente).
Portanto, a mentalidade de confiança zero também deve abordar a melhor forma de gerenciar/minimizar o impacto dessas violações.
A implementação deste princípio varia mais do que a dos demais, mas geralmente se manifesta da seguinte forma:
- Primeiro, identifique quaisquer transações que, embora tecnicamente permitidas pela política, sejam suspeitas. O que é considerado “suspeito” costuma depender muito do contexto, mas as interpretações mais comuns são: (a) transações anômalas, muito diferentes dos comportamentos observados anteriormente; (b) grupos de transações que, individualmente, são normais, mas que, em conjunto, são incomuns — por exemplo, ler e gravar um arquivo pode ser comum, mas ler e gravar a uma taxa de 1.000 arquivos por segundo pode ser incomum; ou (c) ações correlacionadas a um impacto indesejado e nunca antes observado no sistema — um exemplo seria um padrão em que uma transação específica abre uma conexão de rede com um nó TOR ou faz com que a carga da CPU do sistema aumente significativamente.
- Em seguida, realize uma análise mais aprofundada, usando um fluxo de trabalho totalmente automatizado ou híbrido, controlado por humanos e assistido por aprendizado de máquina, para determinar se essas transações são inválidas. Se for constatado que são inválidas, aplique medidas de mitigação. Isso pode assumir a forma de uma atualização geral da política ou, como uma camada adicional de mitigação, de uma “salvaguarda” para as demais medidas de mitigação baseadas em políticas.
Se a abordagem escolhida for usar ajustes baseados em políticas, esses ajustes poderão ser aplicados por meio de qualquer uma das ferramentas de políticas estáticas disponíveis. Exemplos de ajustes baseados em políticas seriam restringir os privilégios de controle de acesso no nível de cada transação (ou seja, não permitir mais que Quem faça O quê a Quem) ou, em vez disso, aplicar um “padrão de comprovação” mais rigoroso (ou seja, exigir MFA ou uma pontuação de confiança mais alta) para que um agente (ou uma classe de agentes) execute uma ação específica.
Se, em vez disso, for escolhida a abordagem de usar uma camada adicional de proteção, essa estratégia também poderá ser implementada com granularidade fina ou grossa. A estratégia de granularidade mais fina seria bloquear exatamente e somente as transações que ultrapassem uma relação específica entre risco e recompensa, embora essa solução também possa acrescentar níveis inaceitáveis de latência a algumas transações permitidas, caso a implementação exija análises adicionais. Como alternativa, poderiam ser usadas estratégias de granularidade mais grossa, como isolar em um ambiente sandbox as futuras transações desse agente ou até mesmo impedir completamente seu acesso ao sistema. Em casos extremos, métodos de mitigação de granularidade ainda mais grossa — como desativar a entrada e saída de arquivos — podem ser apropriados.
É claro que, em condições equivalentes, uma mitigação de última linha de defesa com maior granularidade costuma ser preferível. No entanto, muitas vezes é necessário fazer concessões em função das limitações das tecnologias disponíveis para a solução, e uma última linha de defesa menos granular costuma ser melhor do que nenhuma. Por exemplo, se a resposta menos granular para impedir uma possível ação de ransomware for desativar a entrada e saída de arquivos, os efeitos colaterais dessa resposta ainda podem ser preferíveis à alternativa — permitir que o agente continue operando no sistema sem controle —, supondo que o resultado da inação fosse um sistema de arquivos criptografado por ransomware.
Zero Trust: na verdade, começa antes das operações
O melhor ponto de partida para o desenvolvimento seguro de aplicações usando zero trust é, como era de se esperar, o início. Os princípios fundamentais que permitem colocar o zero trust em prática devem ser incorporados à fase de concepção dos processos de desenvolvimento de aplicações. Portanto, qualquer discussão sobre uma solução operacional de zero trust integrada ao pipeline de CI/CD deve começar pela compreensão desses elementos fundamentais, que devem ser tratados como prioridades na concepção.
O cerne desses elementos fundamentais deve capturar o comportamento desejado ou pretendido das interações entre os comportamentos do sistema, aliado à visibilidade e ao controle suficientes para detectar desvios e agir sobre eles. As interações pretendidas são usadas para definir o conjunto desejado de ações (O quê) de cada agente (Quem) em relação a cada alvo (A quem). Dito isso, pode haver cenários e ambientes em que os padrões de interação pretendidos sejam desconhecidos. Nesses casos, uma organização pode aproveitar uma visibilidade mais aprofundada para “descobrir” o conjunto de interações apropriadas,8 que poderá então formalizar em políticas.
Por exemplo, nas soluções atuais de ZTNA, que se concentram no controle de acesso baseado em identidade às APIs externas de uma aplicação, é necessário ter visibilidade e controle sobre as APIs de autenticação. Já no contexto de uma plataforma de proteção de cargas de trabalho na nuvem (CWPP), a detecção de uma carga de trabalho de contêiner comprometida exige visibilidade das ações executadas por cada contêiner — em tempo real, caso seja necessária uma correção em tempo real.
A seguir, apresentamos uma lista das principais categorias de considerações fundamentais que devem fazer parte do processo de concepção, com detalhamentos adicionais que trazem perguntas específicas para reflexão sobre cada um dos pontos-chave:
- Quais são as interfaces de caixa-preta — entradas e saídas — do sistema?
- Quais são os grupos de usuários – administradores, usuários autenticados, usuários não autenticados, parceiros – que interagem com a aplicação e o que eles precisam fazer?
- Todas as comunicações ocorrem por meio de uma API definida ou há comunicações de rede “diretas” ou comunicações por meio de um repositório de dados, como um banco de dados ou um armazenamento de objetos?
- Para comunicações via API, quão bem definida é a API em relação a quais usuários podem interagir com ela e às restrições dessas interações (por exemplo, restrições de parâmetros, limites de requisições etc.)?
- Em qualquer comunicação de rede, todos os dados são transmitidos de forma criptografada?
- Se houver interfaces de dados “brutos” (por exemplo, informações compartilhadas entre o cliente e a aplicação por meio de um armazenamento de objetos ou banco de dados), existem logs de auditoria para rastrear quem acessou quais informações e quando?
- Da mesma forma, no nível interno de “caixa branca”, quais são os serviços que compõem as aplicações como um todo, incluindo os serviços fornecidos externamente, e como eles se comunicam?
- Como esses serviços se comunicam — qual API é utilizada e quais são as restrições (funções, controles de acesso, limites de requisições, parâmetros etc.) dessas interações?
- Questões semelhantes às mencionadas acima surgem em relação à formalidade da API e suas restrições, bem como à criptografia das comunicações.
- As comunicações “internas” (por exemplo, entre cargas de trabalho/contêineres) têm maior probabilidade de usar memória compartilhada e interfaces baseadas no sistema de arquivos; todas essas interfaces devem ser identificadas.
- Como esses serviços se comunicam — qual API é utilizada e quais são as restrições (funções, controles de acesso, limites de requisições, parâmetros etc.) dessas interações?
- Quais mecanismos de controle o sistema disponibiliza para limitar o acesso às interfaces de caixa-preta e aos canais de comunicação internos?
- Existe uma política que indique quem — quais perfis de acesso — pode chamar APIs específicas e o que acontece se essa política for violada? Da mesma forma, quais mecanismos existem para detectar e mitigar qualquer tipo de uso abusivo das APIs, como parâmetros inválidos ou chamadas em frequência excessiva? Essas políticas podem ser atualizadas dinamicamente com base em informações contextuais de outros sistemas?
- Da mesma forma, existem políticas que restrinjam as outras formas de comunicação entre cargas de trabalho — sistemas de arquivos, armazenamentos de objetos, tabelas de banco de dados — quanto a quem pode acessar quais arquivos/armazenamentos/tabelas e que impeçam o uso abusivo desses recursos (por exemplo, “SELECT * from <table>”)?
- Que visibilidade (painéis, logs, estatísticas) o sistema oferece para limitar o acesso tanto às interfaces de caixa-preta quanto aos canais de comunicação internos?
- O sistema consegue identificar quem está chamando qual API e em que momento? Esses dados são armazenados e, em caso afirmativo, por quanto tempo? Com que rapidez (em tempo real, a cada hora etc.) esses dados são disponibilizados? Qual é a facilidade de uso desses dados — trata-se de um arquivo de log não estruturado, de dados estruturados em JavaScript Object Notation (JSON) que podem ser enviados a um serviço de gerenciamento de eventos e incidentes de segurança (SEIM) ou de dados registrados em uma tabela de banco de dados de big data?
- Quais são as respostas para essas mesmas perguntas quando se trata de outras vias de comunicação — memória, arquivos, objetos, bancos de dados? Quem está fazendo o quê? Como esses dados são expostos?
- Além dos canais de comunicação, quais outros controles e recursos de visibilidade o sistema oferece para evitar a alocação excessiva ou o consumo excessivo de recursos?
- O sistema oferece visibilidade das métricas de consumo de recursos — CPU, memória, largura de banda, escalonamento de pods etc.? Em caso afirmativo, qual é o nível de granularidade e qual é a facilidade de uso desses dados?
- O sistema possui controles ou mecanismos de proteção para o consumo de recursos — limites de memória/CPU/E/S de arquivos por carga de trabalho, monitoramento de chamadas de sistema para criação de processos, limites de escalabilidade vertical e horizontal de pods e limites de taxa de requisições para APIs que invocam outros serviços?
Fazer essas perguntas explicitamente ajudará você a descobrir onde existem lacunas na base necessária para viabilizar a confiança zero. Muitas vezes, o simples ato de perguntar, logo no início do projeto, fará com que a lacuna seja corrigida com um esforço adicional mínimo de projeto. E, quando uma lacuna persistir, o simples conhecimento de sua existência ajudará a direcionar mais atenção à segurança ou a identificar superfícies vulneráveis a ameaças.
Realizar esse tipo de análise prévia de desenvolvimento seguro é uma parte essencial da mentalidade de confiança zero. Apesar disso, grande parte do foco da confiança zero hoje está no que acontece após o projeto inicial, e a maioria das empresas concentra seus esforços nos aspectos da confiança zero posteriores ao projeto. No entanto, considerar cuidadosamente, na fase de projeto, os requisitos para uma implementação eficaz da confiança zero evitará esforços adicionais muito maiores para “tapar os buracos” após a implantação da aplicação.
Considerações sobre mitigação: tempo de resposta, falsos positivos/negativos e risco
Como expressa a premissa de “presumir a violação” dessa mentalidade, um profissional de segurança deve presumir que algum adversário suficientemente motivado conseguirá executar uma transação maliciosa — uma instância de Quem faz O Quê a Quem que atendeu às regras da política, mas que, em um mundo ideal, não deveria ter sido permitida. Nesses casos, o foco passa a ser contar com um mecanismo eficaz de “salvaguarda” capaz de identificar esses casos, geralmente com base na observação de padrões de transações e efeitos colaterais no sistema, conforme descrito na seção anterior sobre “presumir a violação”.
No entanto, assim como ocorre com a noção de identidade, nunca será possível saber com total certeza se uma transação específica é maliciosa ou não. Portanto, assim como no caso da identidade, uma solução ideal de zero trust deve informar uma pontuação de “confiança” na legitimidade da transação. Por exemplo, observar um daemon lendo e gravando arquivos a uma taxa 10 vezes maior que a normal durante 10 segundos pode resultar em uma pontuação de confiança (de que a atividade é maliciosa) de 70%, mas observar essa taxa aumentar para 100 vezes a normal e se manter assim por 1 minuto pode elevar a confiança para 95%. Nesse exemplo, adotar a medida corretiva de impedir futuras gravações de arquivos ainda terá alguma chance (uma probabilidade de 30% ou 5%) de ser a resposta incorreta — um “falso positivo”. Portanto, a decisão de adotar ou não uma medida corretiva deve levar em conta o risco de falsos positivos em comparação com o impacto potencial de permitir o comportamento possivelmente malicioso.
O objetivo do exemplo é destacar que qualquer decisão de tomar uma medida corretiva perceptível ao usuário é, na verdade, uma decisão de negócios que leva em conta todos os riscos, custos e benefícios relacionados à atividade suspeita. Introduzir obstáculos adicionais à transação aumenta a probabilidade de que o valor não seja recebido, mas não intervir nem adicionar obstáculos gera o risco de comprometimento da segurança. Portanto, a decisão de agir (ou não) nesses casos depende de três fatores:
- Qual é o risco de permitir que transações potencialmente maliciosas continuem?
Esse risco pode ser diretamente financeiro, como a transferência de fundos bancários, ou envolver custos indiretos, sejam eles operacionais (por exemplo, registros essenciais criptografados e mantidos sob exigência de resgate) ou relacionados à imagem da marca (por exemplo, a desfiguração de um site). Também pode haver custos jurídicos ou de conformidade, como os decorrentes do vazamento de dados pessoais de clientes. Em essência, a atribuição de riscos é uma questão de governança, e uma boa governança compreenderá e quantificará os riscos para a aplicação. - Quais são os efeitos colaterais de adotar a ação corretiva?
Os efeitos colaterais podem ser expressos em duas dimensões: (a) o atrito introduzido e (b) o raio de impacto. O atrito representa o quanto se torna mais difícil dar continuidade a uma transação legítima; ele pode variar de um pequeno inconveniente adicional (por exemplo, uma etapa extra de autenticação) até a impossibilidade de prosseguir (a transação simplesmente não é permitida). O raio de impacto diz respeito à possibilidade de outras transações independentes também serem afetadas e, em caso afirmativo, quantas. Por exemplo, bloquear um usuário específico afetará apenas esse usuário, mas desativar um serviço de registro de logs afetará a capacidade de auditoria de todos os usuários e transações. - Qual é o grau de confiança na avaliação de que a transação é maliciosa?
Aumentar esse grau de confiança geralmente exige coletar mais dados e correlacionar informações de mais fontes, duas atividades que levam tempo. Por isso, na prática, esse dilema muitas vezes se resume a: “Por quanto tempo devo observar antes de decidir agir?”
Assim, embora uma estratégia de confiança zero deva reconhecer que violações ocorrerão, uma abordagem criteriosa levará em conta a relação entre risco e benefício ao remediar transações permitidas, mas que parecem suspeitas. Essa ponderação considerará o nível de risco das diferentes transações das aplicações e as consequências das medidas de remediação, que só serão aplicadas se o nível de risco superar o benefício esperado para o negócio.
1 https://www.whitehouse.gov/wp-content/uploads/2022/01/M-22-09.pdf
2 https://csrc.nist.gov/publications/detail/sp/800-207/final
3 https://www.cisa.gov/zero-trust-maturity-model
4 https://media.defense.gov/2021/Feb/25/2002588479/-1/-1/0/CSI_EMBRACING_ZT_SECURITY_MODEL_UOO115131-21.PDF
5 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
6 https://dodcio.defense.gov/Portals/0/Documents/Library/(U)ZT_RA_v1.1(U)_Mar21.pdf
7 O planejamento prévio começa na fase de projeto, conforme descrito adiante.
8 Ou, pelo menos, o conjunto de interações “consideradas apropriadas” que o sistema parece exigir. Sempre há o risco de que o conjunto de interações identificado por meio da observação esteja incompleto ou apresente algum risco preexistente. Portanto, é sempre preferível planejar com antecedência durante a elaboração do projeto.
PUBLICADO EM 4 DE MAIO DE 2022