
«Los datos son el nuevo petróleo» o «Los datos son el lubricante de la economía digital». Si eres como yo, probablemente hayas oído estas expresiones, o quizá incluso otra más propia de una escuela de negocios, «monetización de los datos residuales», tantas veces que ya se han convertido en clichés. Pero, como todos los buenos clichés, se basan en una verdad fundamental o, en este caso, en dos verdades complementarias. La primera es que los datos generados como subproducto de los procesos operativos habituales contienen un valor latente. La segunda, relacionada con la anterior pero que a menudo no se menciona, es que el intenso proceso de extraer ese valor latente constituye un recorrido de varias etapas, aunque a lo largo del camino existen fases naturales de evolución y madurez.
Si damos un paso atrás, el concepto de aprovechar los datos de las operaciones para generar valor empresarial no es, desde luego, nuevo. De hecho, los sectores que dependen de la optimización de la logística —como los de la alimentación y el reparto— llevan mucho tiempo comprendiendo y adoptando este concepto. Del mismo modo, la tendencia actual de las empresas hacia la «transformación digital» es una generalización de esta idea, que suele aplicarse primero a los procesos y flujos de trabajo internos de la empresa. Cabe destacar que existe una evolución análoga en el ámbito de las aplicaciones y los servicios de aplicaciones. En este artículo, me gustaría centrarme en cómo la evolución de las aplicaciones y los servicios de aplicaciones interactúa y se armoniza con la gran tendencia de extraer valor de los datos, en qué punto se encuentra hoy esa simbiosis y, por último, hacia dónde se dirige en un futuro próximo.
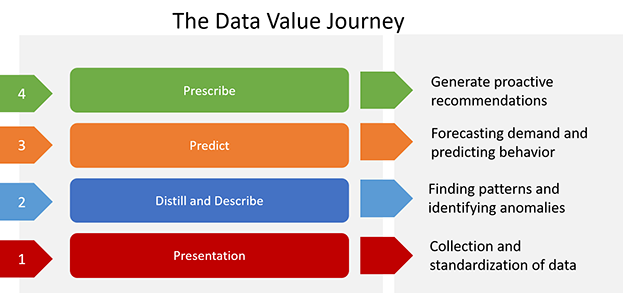
Paso 1: Recopilar y notificar
Este recorrido comienza con la recopilación de datos. Resulta útil pensar en los datos como el combustible del sistema: sin combustible, no se pueden alimentar los motores que realizan el trabajo. A primera vista, parece un hecho consumado, dado que las soluciones de servicios de aplicaciones ofrecen multitud de eventos y estadísticas disponibles para la seguridad, la fiabilidad, la gestión del rendimiento y la orquestación. Sin embargo, los datos suelen carecer de estructura, la sintaxis varía y la semántica suele definirse de manera específica para cada caso. Pensemos en un ejemplo sencillo pero habitual: ¿cómo se representa el concepto de tiempo en los datos? Por lo general, algo tan sencillo desde el punto de vista conceptual como una marca de tiempo puede representarse de muchas formas. Esto pone de manifiesto la necesidad de una lengua franca, una representación común de los «átomos» básicos que describen eventos y estadísticas. En términos tecnológicos, nos referimos a ello como «ingesta de datos», basada en un esquema de datos coherente y que utiliza adaptadores o traductores cuando es necesario. Históricamente, esta necesidad fue uno de los principales factores que impulsaron el crecimiento y el valor de los proveedores de SIEM, que la cubrieron proporcionando este vocabulario normalizado para ofrecer una visión integral de la seguridad en una gran variedad de soluciones de seguridad específicas. La capacidad de obtener como resultado una presentación integrada de los datos —un informe testimonial, organizado e integral, de lo que está sucediendo ahora y de lo que ha sucedido en el pasado— es la fase del recorrido en la que se encuentra actualmente la mayor parte del sector. En el ecosistema actual de las aplicaciones, esto se refleja principalmente en los segmentos de mercado de SIEM y APM.
Paso 2: Sintetizar y describir
El siguiente paso del proceso consiste en interpretar los informes de los testigos presenciales: buscar elementos comunes, sintetizar los datos en patrones que puedan describirse e identificar anomalías. Debido al volumen de datos implicado, las personas suelen contar con la ayuda de ordenadores o utilizar estos para ampliar sus capacidades en esta tarea. Esta ayuda puede consistir en el uso de técnicas avanzadas de clasificación estadística, a menudo no supervisadas y, en ocasiones, complementadas con la exploración y visualización de datos guiadas por personas.
Un ejemplo del ámbito de la protección contra ataques de denegación de servicio (DoS) es la visualización de la procedencia geográfica del tráfico entrante, que suele utilizarse para identificar tráfico malicioso originado en un pequeño grupo de países. Otro ejemplo son las herramientas de análisis del comportamiento de los usuarios ("UBA"), que caracterizan los atributos del comportamiento humano frente al de los bots. Estas soluciones suelen utilizar análisis estadísticos para determinar la probabilidad de que una interacción web proceda de una persona.
Esta fase del recorrido —«Depurar y describir»— supone una evolución con respecto a la etapa anterior, «Recopilar y elaborar informes». Sigue dependiendo, como base fundamental, de disponer de un conjunto amplio y estructurado de datos sobre el que aplicar el análisis. Como se ha mencionado anteriormente, este enfoque constituye la base de algunas de las soluciones específicas más recientes (aunque de alcance limitado) para la seguridad de las aplicaciones.
Paso 3: Inferir y predecir
El tercer paso de este recorrido consiste en ir más allá del modesto análisis de «Sintetizar y describir» para realizar inferencias analíticas más profundas que den lugar a predicciones y pronósticos sobre futuras observaciones previstas. De este modo, la solución deja de ser meramente reactiva, ya que realiza extrapolaciones inteligentes sobre el comportamiento futuro esperado. Un ejemplo en la capa de infraestructura de aplicaciones se encuentra en el ámbito de la gestión del rendimiento de aplicaciones (APM): concretamente, la identificación de patrones de comportamiento temporales y su uso para prever las necesidades futuras de recursos. Otro ejemplo, basado en un caso de uso de la lógica de negocio de una aplicación, es cómo los sitios web de viajes utilizan técnicas de aprendizaje automático («ML») para predecir la oferta y la demanda de rutas específicas en fechas futuras. Las tecnologías que se emplean aquí con mayor frecuencia son tecnologías de análisis avanzado, especialmente las basadas en técnicas de series temporales y regresión lineal, que aprovechan los patrones de datos detectados en el paso anterior.
Paso 4: Razonar y prescribir
El cuarto y último paso consiste en «cerrar el ciclo» para aplicar ajustes y medidas correctivas en todo el sistema. El análisis de los dos pasos anteriores se traduce en un conjunto de recomendaciones proactivas. En este punto, el sistema se vuelve adaptable y resistente frente a los ataques y los cambios en su entorno. Por ejemplo, una infraestructura de aplicaciones conceptual que utilizara esta capacidad podría crear o eliminar de forma proactiva instancias de cargas de trabajo en contenedores en función de la demanda prevista. O bien, en el contexto de la seguridad de las aplicaciones, podría filtrar proactivamente el tráfico generado por redes de bots basándose en comportamientos de estas redes aprendidos previamente. En la actualidad ya existe un ejemplo destacado en el ámbito de la lógica empresarial: la fijación dinámica de precios, basada también en la oferta y la demanda previstas.
La tecnología subyacente suele basarse en reglas, que se utilizan para convertir las predicciones en acciones. Sin embargo, en el contexto de la infraestructura y los servicios de aplicaciones, este enfoque suele combinarse con directivas de configuración y orquestación más declarativas o basadas en intenciones.
Acelerar el camino
Este recorrido —desde «Recopilar e informar», pasando por «Depurar y describir» e «Inferir y predecir», hasta llegar finalmente a «Razonar y prescribir»— constituye una evolución natural. Cada avance incremental se apoya en los anteriores y abre la puerta a un nuevo nivel de valor más profundo. En la actualidad, las soluciones disponibles para abordar los retos en los ámbitos de la infraestructura y los servicios de aplicaciones presentan distintos grados de madurez a lo largo de este proceso de extracción de valor de los datos y, por lo general, no están bien integradas entre la multitud de soluciones específicas existentes.
El paso previo que lo hace posible —el proverbial «combustible» del «motor» de datos— consiste en obtener visibilidad sobre un amplio conjunto de servicios de aplicaciones. Esta instrumentación, desplegada en múltiples puntos de la cadena de entrega de aplicaciones y combinada con los principios de una semántica de datos coherente y repositorios de datos federados, es una de las formas en que F5 está acelerando nuestro avance hacia el futuro de los servicios de aplicaciones. Tenemos la intención de acelerar aún más el ritmo al que aportamos valor a nuestros clientes, ampliando simultáneamente el embudo de datos para facilitar una mejor integración de soluciones específicas y agilizando el desarrollo avanzado de los componentes tecnológicos pertinentes.
En futuros artículos, espero profundizar en la arquitectura guiada por datos, tanto acercando el foco para ahondar en las tecnologías fundamentales implicadas como ampliándolo para examinar las interacciones entre múltiples ecosistemas de datos a través de diversas canalizaciones de datos soberanas.
Sobre el autor
Artículos relacionados del blog

Proteger los endpoints de las API dificulta la seguridad de las API
Descubre las complejidades de la seguridad de las API, los retos a los que se enfrentan las organizaciones, la evolución de los ataques contra endpoints de API y la necesidad de políticas de seguridad adaptadas.
¿Qué es el sesgo de la IA y por qué es importante para TI?
Descubre los fundamentos del aprendizaje de la IA. Aprende cómo pueden surgir sesgos en la IA y qué riesgos plantean para las TI y la transformación digital.
Redefiniendo la ciberseguridad en el extremo de la nube distribuida con IA y telemetría en tiempo real
La transformación digital y la adopción de tecnologías en la nube están provocando cambios en las arquitecturas de las aplicaciones. Estos cambios introducen nuevas superficies de ataque, que son el objetivo de métodos de ataque avanzados, altamente organizados y con motivaciones económicas. Mediante el uso del framework Morpheus de NVIDIA, F5 está investigando técnicas para detectar estas amenazas avanzadas con telemetría en tiempo real y análisis basados en IA.
El papel de la nube en las aplicaciones nativas del edge
No debería sorprender que, al igual que la aparición de la nube dio lugar a las aplicaciones nativas de la nube, el edge esté impulsando un conjunto de aplicaciones nativas del edge. Sin embargo, estas aplicaciones no residirán únicamente en el edge. Al mismo tiempo, están surgiendo nuevos patrones arquitectónicos que aprovechan las aplicaciones alojadas en la nube y en el centro de datos.
La creciente diversidad de ubicaciones y usuarios está impulsando a las empresas hacia el edge
En el contexto del ámbito de las aplicaciones, el término «usuario» siempre se ha referido a la entidad que interactúa con una aplicación. Del mismo modo que los cambios en las arquitecturas de las aplicaciones impulsan cambios en las tecnologías que permiten ofrecerlas y protegerlas, los cambios en la definición de usuario han provocado cambios en los lugares donde se despliegan las aplicaciones.
El edge está impulsando un renacimiento de las infraestructuras
A medida que las organizaciones aumentan la generación de datos y tratan de extraer valor empresarial de ellos, sin duda recurrirán a la analítica y la automatización basadas en la IA y el aprendizaje automático. Precisamente este tipo de cargas de trabajo son las que más se beneficiarían de una infraestructura optimizada y, sin embargo, hoy en día son las que menos probabilidades tienen de poder aprovecharla.